Un ransomware può bloccare ordini, pagamenti e servizi in poche ore, ma il problema raramente nasce da un solo computer. Il cyber risk management aiuta a collegare tecnologia, persone e processi per capire quali minacce possono danneggiare davvero l’azienda e quali contromisure meritano priorità. In queste righe mostro un metodo pratico per valutare l’esposizione, ridurre i rischi più urgenti e prepararsi a reagire senza improvvisare.
La sicurezza informatica funziona quando protegge le attività che contano davvero
- Partire dagli asset critici è più utile che controllare ogni sistema con la stessa intensità.
- La valutazione deve unire probabilità e impatto, includendo fornitori, cloud e comportamenti interni.
- MFA, backup testati, patch e segmentazione riducono concretamente la superficie d’attacco.
- Un piano valido stabilisce chi decide, cosa fare e in quanto tempo durante un incidente.
- Il miglioramento va misurato con indicatori semplici e verificato con test periodici.
Che cosa significa gestire il rischio cyber in azienda
Gestire il rischio informatico significa prendere decisioni consapevoli sull’esposizione digitale dell’organizzazione. Non vuol dire eliminare ogni minaccia, obiettivo irrealistico, ma portare il rischio entro un livello compatibile con il valore dell’attività e con la sua capacità di assorbire un incidente.
Io distinguo sempre tre elementi. La minaccia è ciò che può causare il danno, come un attacco phishing o un ransomware. La vulnerabilità è il punto debole sfruttabile, per esempio una password riutilizzata o un software non aggiornato. L’impatto descrive invece cosa succede al business, dai dati sottratti all’interruzione della produzione.
Questa distinzione evita un errore frequente. Un’azienda può avere molte vulnerabilità tecniche, ma non tutte meritano lo stesso investimento. Un vecchio server non collegato a processi importanti può essere meno urgente di un account amministrativo usato per accedere al gestionale, anche se il primo presenta più problemi rilevati da uno scanner.
Il modello NIST CSF 2.0 organizza il percorso in sei funzioni utili anche alle imprese italiane: Govern, Identify, Protect, Detect, Respond e Recover. Non è necessario adottarlo alla lettera, ma la sequenza ricorda una cosa essenziale: la sicurezza non è soltanto prevenzione, comprende anche rilevazione, risposta e ripristino.
Dalla superficie digitale alle priorità vere
La prima attività concreta è costruire un inventario aggiornato. Server, notebook, smartphone, applicazioni SaaS, account cloud, dispositivi industriali, dati dei clienti e fornitori con accesso ai sistemi devono comparire nello stesso quadro. Se un elemento non è censito, difficilmente può essere protetto o recuperato con rapidità.
Classificare ciò che non può fermarsi
Per ogni asset assegno almeno quattro caratteristiche: proprietario, dati trattati, dipendenze e conseguenza di un fermo. Un e-commerce, ad esempio, può dipendere dal provider cloud, dal sistema di pagamento e dal servizio di autenticazione. Il rischio non sta quindi in un solo componente, ma nella catena di dipendenze.
Una classificazione semplice può usare tre livelli. Critico indica un servizio il cui blocco compromette ricavi, sicurezza o obblighi contrattuali. Importante identifica sistemi con impatto significativo ma con alternative temporanee. Standard comprende strumenti che possono essere ripristinati in un secondo momento.
Valutare il rischio con un metodo ripetibile
Per evitare valutazioni basate sull’impressione, si può assegnare un punteggio da 1 a 5 alla probabilità e un altro da 1 a 5 all’impatto. La moltiplicazione produce un indice da 1 a 25, utile per ordinare il lavoro. Non è una misura scientifica del pericolo, ma rende trasparenti le scelte e permette di confrontare periodi diversi.
| Classe | Punteggio indicativo | Azione consigliata |
|---|---|---|
| Critica | 16-25 | Intervento immediato e monitoraggio della direzione |
| Alta | 10-15 | Piano con responsabile e scadenza ravvicinata |
| Media | 5-9 | Riduzione programmata e verifica periodica |
| Bassa | 1-4 | Accettazione documentata o trattamento ordinario |
La parte più delicata è stimare l’impatto. Chiedo sempre quanto costerebbe un’ora di indisponibilità, quali dati potrebbero essere esposti e quali clienti o processi verrebbero coinvolti. Questa prospettiva porta la discussione fuori dal gergo IT e la trasforma in una decisione economica e operativa.
Quali misure riducono davvero l’esposizione
Una volta definite le priorità, le contromisure devono seguire il rischio e non la moda del momento. Comprare una nuova piattaforma senza sapere quali asset protegge o chi la gestirà crea soltanto un altro sistema da amministrare.
Le basi che non devono mancare
- Autenticazione multifattore per account amministrativi, accessi remoti, posta elettronica e applicazioni cloud.
- Gestione centralizzata delle identità, con rimozione degli account non più necessari e privilegi assegnati secondo il principio del minimo accesso.
- Inventario delle vulnerabilità e applicazione delle patch con priorità ai sistemi esposti su Internet e agli asset critici.
- Backup separati e verificati, con almeno una copia non facilmente modificabile dalla rete aziendale.
- Segmentazione della rete, così che la compromissione di un dispositivo non apra automaticamente l’accesso a tutti gli altri.
- Registrazione dei log e alert sulle attività anomale, soprattutto per accessi privilegiati e trasferimenti insoliti di dati.
Il backup è un buon esempio di controllo spesso sopravvalutato. Avere una copia non significa poter ripartire: bisogna conoscere il tempo di ripristino, verificare che i dati siano leggibili e sapere chi possiede le credenziali. Io pianificherei un test di recupero almeno trimestrale per i servizi più importanti, documentando il risultato e gli ostacoli incontrati.
Protezione e continuità non sono la stessa cosa
Un antivirus evoluto può individuare un comportamento sospetto, ma non impedisce da solo l’errore di un dipendente, l’abuso di un account o il disservizio di un fornitore. Per questo abbino sempre le misure preventive a obiettivi di continuità come RTO e RPO.
L’RTO indica entro quanto tempo un servizio deve tornare operativo. L’RPO indica quanti dati si possono perdere rispetto all’ultimo salvataggio disponibile. Un gestionale ordini potrebbe richiedere un RTO di 4 ore e un RPO di 1 ora, mentre un archivio storico può tollerare tempi più lunghi. Sono valori da concordare con il business, non da scegliere solo dal reparto tecnico.
Persone, fornitori e incidenti fanno la differenza
La formazione contro il phishing serve, ma una lezione annuale non basta. Le persone devono sapere come verificare una richiesta urgente di pagamento, dove segnalare un messaggio sospetto e cosa fare dopo aver cliccato. Brevi esercitazioni ripetute, con risultati condivisi senza colpevolizzazioni, cambiano più comportamenti di un corso teorico di tre ore.
Per gli account ad alto privilegio introdurrei procedure più rigide, come approvazione a due persone per operazioni sensibili e revisione degli accessi ogni 90 giorni. L’obiettivo non è rallentare tutto, ma rendere più difficile che un singolo errore provochi un danno esteso.
Il rischio della catena di fornitura
Un’azienda può avere controlli solidi e restare vulnerabile attraverso il provider che gestisce paghe, CRM, assistenza o infrastruttura cloud. Per ogni fornitore critico verifico almeno accessi disponibili, localizzazione dei dati, tempi di notifica, backup, gestione delle vulnerabilità e modalità di uscita dal servizio.
Non chiederei a una piccola software house lo stesso livello documentale richiesto a un grande outsourcer, ma pretenderei sempre evidenze verificabili. Una certificazione può aiutare, tuttavia non sostituisce domande concrete su incidenti, subfornitori e tempi di ripristino.
Leggi anche: Social media phishing, come riconoscere le truffe e reagire
Un piano di risposta che qualcuno sappia usare
Durante un attacco le prime ore sono confuse. Il piano deve indicare chi può isolare un dispositivo, chi informa la direzione, chi contatta il legale, chi gestisce i clienti e chi valuta eventuali obblighi di notifica. Anche l’eventuale applicazione della direttiva NIS2 dipende dal settore, dalle dimensioni e dal ruolo dell’organizzazione, quindi la verifica va fatta con competenze legali e tecniche adeguate.
Prevedo almeno due esercitazioni l’anno per i processi più esposti. Una può simulare il furto di un account, l’altra l’indisponibilità del fornitore cloud. ENISA insiste sull’utilità delle esercitazioni per sviluppare resilienza e coordinamento, e nella pratica il loro valore sta soprattutto nel far emergere responsabilità non assegnate e contatti obsoleti.
Misurare i progressi senza riempire fogli inutili
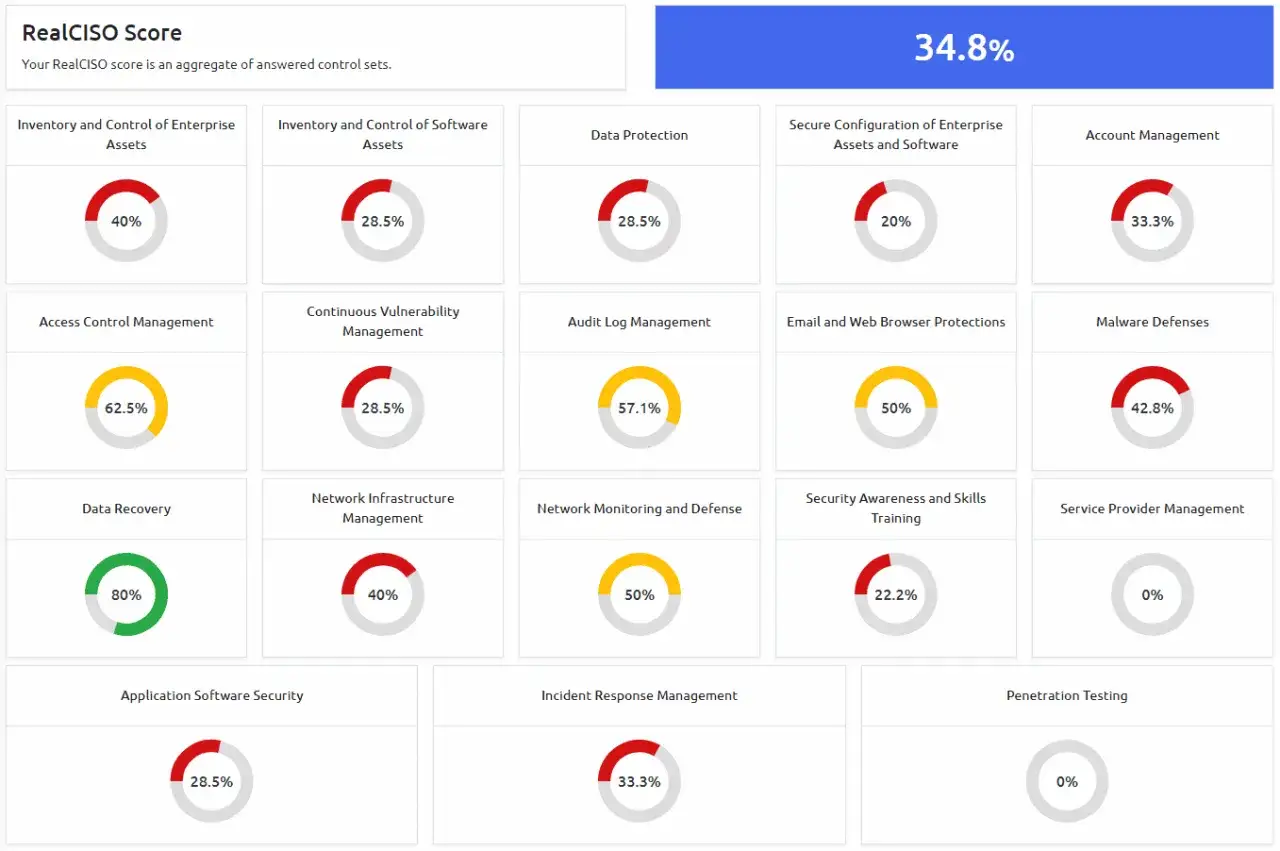
Un programma di sicurezza ha bisogno di pochi indicatori leggibili. Monitorerei, per esempio, la percentuale di account protetti da MFA, il tempo medio di applicazione delle patch critiche, la quota di asset inventariati, il risultato dei test di ripristino e il tempo necessario per chiudere gli accessi dei dipendenti usciti.
Per una piccola impresa è più utile una dashboard con 5-7 metriche aggiornate ogni mese che un rapporto di cinquanta pagine letto una volta all’anno. Ogni indicatore deve avere un responsabile, una soglia e un’azione associata. Se il tempo di patching supera la soglia, per esempio, la direzione deve sapere se servono più risorse, una modifica del processo o la sostituzione di un sistema obsoleto.
Il budget va distribuito secondo il rischio residuo. Prima finanzierei identità, backup, patching e risposta agli incidenti; solo dopo valuterei strumenti più sofisticati. La tecnologia avanzata può fare la differenza in un ambiente maturo, ma non compensa password deboli, asset sconosciuti o backup mai provati.
La regola pratica per non lasciare il rischio sulla carta
Il modo più concreto per iniziare è fissare un ciclo di 90 giorni. Nei primi 30 si censiscono asset, dati, fornitori e accessi; nei successivi 30 si correggono le esposizioni più gravi; nell’ultimo mese si testano backup, allarmi e piano di risposta. Alla fine non serve promettere sicurezza assoluta, serve poter dimostrare quali rischi sono stati ridotti e quali decisioni restano da prendere.
La maturità informatica non si vede dal numero di strumenti acquistati, ma dalla rapidità con cui l’azienda riconosce un problema, limita il danno e torna operativa. Se il processo diventa parte delle riunioni di business e delle decisioni sui fornitori, la sicurezza smette di essere un costo isolato e diventa una condizione concreta per innovare con maggiore fiducia.
