Un attacco ransomware può fermare ordini, produzione e pagamenti in poche ore. In questo articolo chiarisco che cosa significa davvero cyber resilience, come si costruisce la capacità di resistere e recuperare dopo un incidente e quali misure pratiche possono adottare le aziende italiane, anche quando il budget e il personale IT sono limitati.
La resilienza informatica si misura nella capacità di continuare a operare
- Non basta prevenire: bisogna saper rilevare, contenere, ripristinare e imparare dall’incidente.
- Backup verificati, autenticazione multifattore e sistemi prioritari riducono il danno reale.
- RTO e RPO trasformano la continuità operativa in obiettivi misurabili.
- NIS2 e DORA rendono governance, gestione dei fornitori e test periodici sempre più importanti.
- Le esercitazioni fanno emergere prima della crisi i punti deboli del piano.
Che cosa significa davvero la resilienza informatica
La resilienza informatica è la capacità di un’organizzazione di prepararsi, assorbire un attacco, mantenere i servizi essenziali e tornare alla normalità. Non coincide quindi con l’assenza di incidenti. Un’azienda resiliente sa che prima o poi dovrà affrontare un phishing riuscito, un errore umano, un guasto cloud o una compromissione della catena di fornitura.
Secondo il NIST, il concetto comprende anche la capacità di adattarsi dopo una crisi. È un passaggio importante, perché ripristinare i server senza correggere la causa dell’incidente significa prepararsi a ripetere lo stesso problema. La mia regola è semplice: la sicurezza riduce la probabilità dell’attacco, la resilienza limita le conseguenze.
| Approccio | Domanda principale | Risultato atteso |
|---|---|---|
| Sicurezza informatica | Come impediamo l’accesso non autorizzato? | Prevenzione, protezione e rilevamento |
| Risposta agli incidenti | Come limitiamo il danno nelle prime ore? | Contenimento e coordinamento |
| Continuità operativa | Come manteniamo attivi i processi critici? | Servizi essenziali disponibili |
| Resilienza informatica | Come recuperiamo e miglioriamo dopo l’evento? | Ripristino, adattamento e apprendimento |
Questo approccio vale per una banca, ma anche per una piccola azienda manifatturiera. Se il gestionale, il sistema di ordini o l’accesso alla posta si bloccano, il rischio non è soltanto tecnico. Diventa un problema di ricavi, reputazione, contratti e fiducia dei clienti.
Da dove partire per costruire una difesa concreta
Il primo passo non è acquistare un nuovo software. È capire quali attività non possono fermarsi e da quali sistemi, persone e fornitori dipendono. Io partirei da una mappa molto pratica, con cinque colonne per ogni processo critico: responsabile, applicazioni utilizzate, dati trattati, dipendenze esterne e tempo massimo di indisponibilità.
Identificare ciò che mantiene in piedi l’azienda
Un inventario utile non elenca soltanto computer e indirizzi IP. Deve includere account privilegiati, servizi cloud, backup, fornitori ICT, connessioni remote e dati indispensabili. Un sistema apparentemente secondario può diventare essenziale se, per esempio, gestisce le identità o permette di fatturare.
Per ogni servizio conviene stabilire un livello di priorità. Un portale informativo può restare offline per alcune ore senza bloccare l’azienda; un sistema di produzione o di pagamento potrebbe richiedere un ripristino molto più rapido. Senza questa distinzione, le risorse vengono distribuite in modo uniforme e spesso finiscono dove il danno sarebbe minore.
Ridurre i punti di accesso più rischiosi
- Attivare la MFA, cioè l’autenticazione con almeno due fattori, per amministratori, posta elettronica, VPN e servizi cloud.
- Applicare gli aggiornamenti alle vulnerabilità critiche con tempi definiti, dando priorità ai sistemi esposti a Internet.
- Separare le reti e gli account amministrativi, così un singolo accesso compromesso non apre l’intera infrastruttura.
- Registrare e conservare i log, ossia le tracce delle attività, per individuare comportamenti anomali.
- Formare il personale con simulazioni brevi e ricorrenti, non soltanto con un corso annuale dimenticato dopo pochi giorni.
La tecnologia conta, ma la governance conta altrettanto. Un’azienda può avere un ottimo firewall e non sapere chi deve autorizzare lo spegnimento di un server infetto. In emergenza, un ruolo assegnato in anticipo vale più di una riunione improvvisata.
Come reagire nelle prime ore di un incidente
Quando si sospetta una compromissione, l’obiettivo iniziale non è capire tutto. È evitare che il problema si allarghi. Un piano efficace indica chi decide, chi raccoglie le evidenze, chi parla con i fornitori e chi aggiorna direzione, dipendenti e clienti.
- Confermare l’evento senza cancellare log, email o altri elementi utili all’analisi.
- Contenere la propagazione isolando dispositivi, account o segmenti di rete compromessi.
- Proteggere le funzioni essenziali passando, quando possibile, a procedure manuali o sistemi alternativi.
- Attivare il piano di comunicazione e valutare gli obblighi di notifica previsti dalla legge e dai contratti.
- Eradicare la causa, verificare l’integrità degli ambienti e procedere al ripristino in ordine di priorità.
Due indicatori rendono il piano più concreto. L’RTO indica il tempo massimo accettabile per ripristinare un servizio; l’RPO indica quanta perdita di dati si può tollerare, misurata nel tempo. Per un sistema ordini, un obiettivo potrebbe essere RTO di 4 ore e RPO di 15 minuti, mentre per un archivio storico potrebbero essere accettabili tempi molto più lunghi.
Questi numeri non sono promesse automatiche. Per rispettare un RTO di 4 ore servono backup disponibili, persone reperibili, credenziali di emergenza, procedure provate e infrastruttura sufficiente. Se uno solo di questi elementi manca, il valore resta scritto su un documento e non nella realtà.
Non trascurerei neppure la comunicazione. Un messaggio interno chiaro può impedire che i dipendenti riaccendano dispositivi isolati o diffondano informazioni incomplete. Nei casi più seri, la trasparenza tempestiva protegge la fiducia più di una rassicurazione generica.
Backup e ripristino devono funzionare anche sotto pressione
Molte aziende dichiarano di avere un backup, ma non hanno mai provato a ripristinare un ambiente completo. È una differenza sostanziale. Un file salvato correttamente non garantisce che il database, le configurazioni, le chiavi di cifratura e le dipendenze applicative possano tornare operativi insieme.
Una strategia di backup più solida
Il modello 3-2-1 resta un buon punto di partenza: tre copie dei dati, su due supporti diversi, con una copia fuori sede. Per difendersi dal ransomware aggiungerei una copia offline o immutabile, cioè non modificabile nemmeno da un account amministrativo compromesso.
La frequenza dipende dal valore del dato. Un sistema transazionale può richiedere copie frequenti o replica continua; documenti meno dinamici possono essere salvati una o poche volte al giorno. La scelta deve derivare dall’RPO, non dall’impostazione predefinita del prodotto acquistato.
Leggi anche: Attacco informatico - come riconoscerlo e reagire
Il test che molti rimandano
Io pianificherei almeno un test di ripristino trimestrale per i sistemi più importanti e una simulazione organizzativa ogni sei mesi. Il test deve verificare non solo se i dati esistono, ma se l’azienda riesce davvero a riaprire l’applicazione, autenticare gli utenti e svolgere il processo di lavoro.
È utile misurare il tempo reale di recupero, gli errori incontrati e le persone coinvolte. Se il ripristino richiede 18 ore mentre il piano ne prevede 4, non è un fallimento del test. È una scoperta preziosa, perché permette di correggere il piano prima di un incidente vero.
Come misurare se la resilienza sta migliorando
La resilienza non si dimostra con il numero di strumenti presenti nel catalogo IT. Si dimostra con risultati verificabili. Un cruscotto essenziale può contenere pochi indicatori, purché siano aggiornati e collegati ai processi aziendali.
| Indicatore | Che cosa misura | Come interpretarlo |
|---|---|---|
| MTTD | Tempo medio per rilevare un incidente | Più è basso, prima si può contenere l’attacco |
| MTTR | Tempo medio per risolvere e ripristinare | Va confrontato con gli RTO dei servizi critici |
| Copertura MFA | Percentuale di account protetti | Gli account privilegiati dovrebbero avere priorità assoluta |
| Backup verificati | Percentuale di copie testate con esito positivo | Una copia mai ripristinata non offre una garanzia completa |
| Tempo di applicazione delle patch | Giorni necessari per correggere vulnerabilità importanti | Va misurato soprattutto sui sistemi esposti |
| Esito delle esercitazioni | Problemi emersi durante simulazioni e test | Il valore sta nella chiusura delle azioni correttive |
Un buon indicatore deve avere un proprietario e una soglia. Per esempio, si può puntare al 100% di MFA sugli account amministrativi, al test trimestrale dei backup critici e alla chiusura delle vulnerabilità ad alto rischio entro un termine definito dall’analisi di esposizione.
Non inseguirei però una perfezione astratta. Una piccola impresa con dieci sistemi prioritari può ottenere un progresso enorme concentrandosi su quelli, invece di tentare di controllare ogni dispositivo con lo stesso livello di dettaglio. La proporzionalità è una scelta strategica, non una scusa per ignorare i rischi.
Che cosa cambiano NIS2, DORA e la gestione dei fornitori
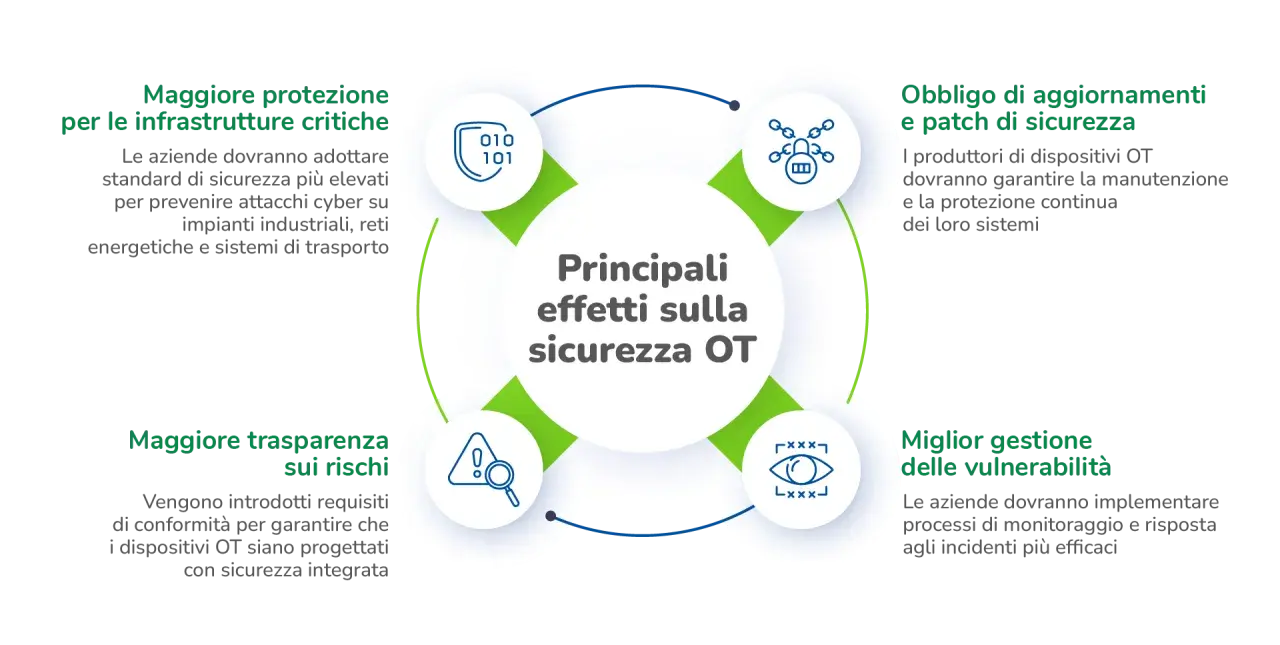
In Europa la resilienza non è più soltanto una questione tecnica. La direttiva NIS2 amplia l’attenzione su gestione del rischio, continuità, incidenti, vulnerabilità e sicurezza della catena di fornitura. Per le organizzazioni italiane coinvolte, questo significa dimostrare che esistono responsabilità, procedure e controlli effettivi, non solo documenti preparati per un audit.
Per il settore finanziario, DORA introduce requisiti specifici sulla resilienza operativa digitale, sulla gestione degli incidenti, sui test e sui fornitori ICT. La differenza pratica è rilevante: una banca o un intermediario deve valutare anche la dipendenza da cloud provider, software house e altri partner essenziali.
La mia raccomandazione è creare un registro dei fornitori con almeno questi dati:
- servizio fornito e processo aziendale dipendente;
- tipo di dati trattati e loro posizione;
- tempo di ripristino dichiarato e tempo effettivamente testato;
- responsabilità in caso di incidente;
- modalità di accesso, revoca e restituzione dei dati;
- piano di uscita se il fornitore non è più disponibile.
Non confonderei inoltre la direttiva NIS2 con il Cyber Resilience Act. La prima riguarda soprattutto la sicurezza e la resilienza delle organizzazioni e dei servizi; il secondo si concentra sui prodotti con elementi digitali e sugli obblighi dei produttori. Sono collegati, ma non risolvono lo stesso problema.
La conformità può aiutare a ordinare le priorità, ma non sostituisce la capacità operativa. Un’azienda può rispettare formalmente una serie di requisiti e scoprire comunque, durante un test, che nessuno sa usare il backup o contattare il fornitore giusto.
Gli errori che indeboliscono anche i programmi ben finanziati
Il primo errore è proteggere soltanto il perimetro. Oggi gli ambienti aziendali comprendono cloud, dispositivi mobili, accessi remoti e applicazioni di terze parti. La resilienza richiede visibilità sull’intero ecosistema, non solo sulla rete interna.
Il secondo è considerare la formazione una formalità. Un dipendente che riconosce un messaggio sospetto e lo segnala nei primi minuti può ridurre molto l’impatto. Per ottenere questo risultato servono istruzioni semplici, un canale di segnalazione rapido e un ambiente in cui l’errore venga comunicato senza paura.
Il terzo errore è concentrare tutto su un’unica persona. Se solo l’amministratore di sistema conosce le procedure, l’azienda resta fragile durante ferie, malattia o crisi. Servono almeno due persone formate per ogni attività critica e credenziali di emergenza conservate in modo sicuro.
Infine, molte organizzazioni trascurano i fornitori più piccoli. Un partner con accesso remoto, anche se non gestisce dati sensibili, può diventare una porta d’ingresso. La valutazione deve guardare agli accessi e alle dipendenze reali, non soltanto alla dimensione commerciale del fornitore.
La prova decisiva arriva prima dell’attacco
Per costruire una buona resilienza non serve iniziare con un progetto enorme. Si può partire da cinque sistemi critici, definire RTO e RPO realistici, proteggere gli account privilegiati, verificare i backup e simulare un incidente con le persone che dovrebbero davvero intervenire.
Se il test fa emergere lacune, il lavoro non è andato perso. Ha trasformato un rischio invisibile in un piano di miglioramento concreto. È questa, a mio avviso, la differenza tra un’azienda che possiede strumenti di sicurezza e un’organizzazione capace di continuare a funzionare quando qualcosa va storto.
