Un attacco può restare nascosto anche quando antivirus, firewall e sistemi di monitoraggio sembrano funzionare correttamente. Il threat hunting serve proprio a cercare in modo proattivo segnali di compromissione già presenti nella rete, collegando dati tecnici, comportamenti anomali e informazioni sulle minacce. In questo articolo mostro come funziona, quali strumenti servono, come organizzare un’attività concreta e quali risultati aspettarsi in azienda.
La ricerca proattiva riduce il tempo in cui un attaccante resta inosservato
- Obiettivo: individuare attività malevole che hanno superato i controlli automatici.
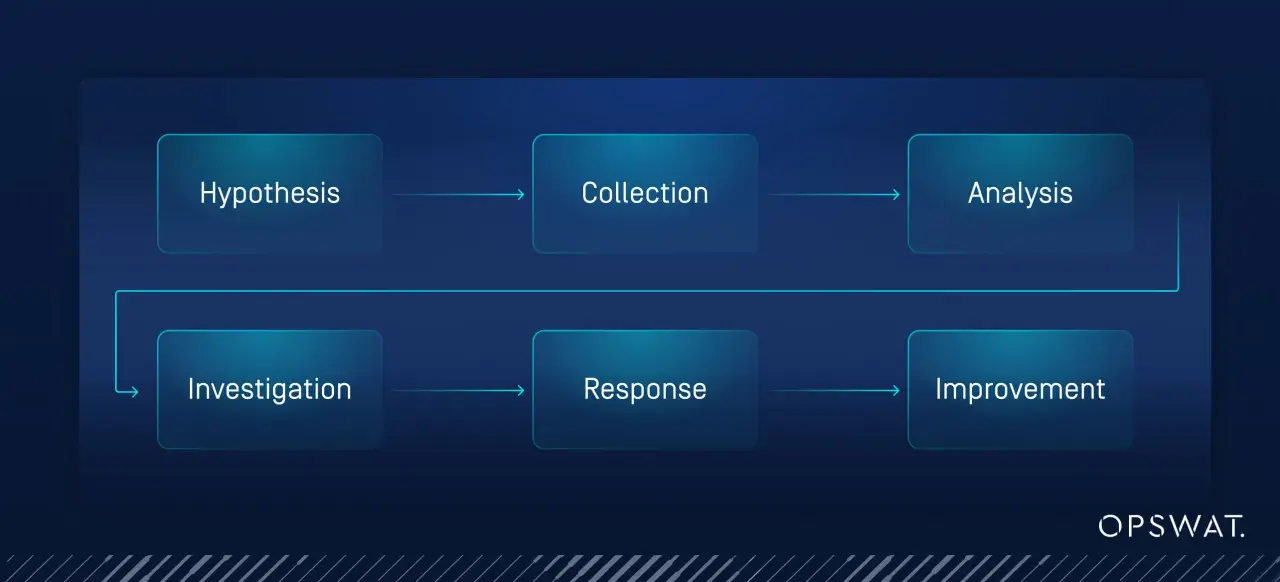
- Metodo: partire da un’ipotesi, analizzare i dati e verificare il comportamento nella rete.
- Dati utili: log del SIEM, telemetria EDR, identità, DNS, cloud e traffico di rete.
- Risultato: scoprire minacce, correggere lacune e migliorare le regole di rilevamento.
- Condizione necessaria: dati completi, personale competente e un processo documentato.
Che cosa significa cercare una minaccia prima dell’allarme
La ricerca proattiva delle minacce consiste nell’esaminare sistemi, account, endpoint e traffico di rete per trovare comportamenti sospetti, anche quando non esiste ancora un alert. L’idea è semplice: non aspettare che un sistema di sicurezza confermi l’incidente, ma verificare se l’attaccante ha già lasciato tracce nell’ambiente aziendale.
Un analista non cerca soltanto file malevoli o indirizzi IP già conosciuti. Può analizzare, per esempio, un accesso da una località insolita seguito dal download massivo di documenti, l’uso anomalo di PowerShell o una connessione tra due server che normalmente non comunicano. Presi singolarmente, questi segnali possono avere una spiegazione legittima; osservati insieme, possono indicare un’attività di intrusione.
Questa disciplina è soprattutto basata su ipotesi. L’analista formula una domanda verificabile, come “un account compromesso sta usando strumenti amministrativi per muoversi lateralmente?”, e cerca evidenze che la confermino o la smentiscano.
La differenza rispetto a una scansione automatica è importante. Un prodotto può segnalare un comportamento già previsto dalle sue regole, mentre l’hunter esplora relazioni, eccezioni e sequenze di eventi che non sono ancora state codificate. Per questo l’attività combina automazione e giudizio umano.
Come si distingue dal monitoraggio e dalla risposta agli incidenti
Monitoraggio, threat hunting e incident response fanno parte dello stesso sistema difensivo, ma rispondono a momenti diversi. Confonderli porta spesso a comprare strumenti costosi senza costruire un processo realmente utile.
| Attività | Domanda principale | Modalità di lavoro |
|---|---|---|
| Monitoraggio SOC | Sta accadendo qualcosa di sospetto in questo momento? | Analisi continua degli alert e prioritizzazione degli eventi. |
| Threat hunting | Una minaccia potrebbe essere già presente senza aver generato un alert? | Ricerca mirata, guidata da ipotesi e intelligence. |
| Incident response | Come contenere e risolvere un incidente confermato? | Isolamento, raccolta delle prove, rimozione e ripristino. |
| Penetration test | Quali vulnerabilità possono essere sfruttate? | Simulazione controllata di tecniche d’attacco. |
Un penetration test può dimostrare che una vulnerabilità è sfruttabile, ma non dice necessariamente se qualcuno la sta usando oggi. La risposta agli incidenti, invece, entra in azione quando esiste un sospetto concreto o una conferma. La ricerca proattiva si colloca prima, cercando attività che potrebbero essere sfuggite ai controlli.
Nella pratica, i risultati di un’attività alimentano le altre. Un hunt può scoprire una tecnica non rilevata dal SIEM; il team di detection engineering trasforma quella scoperta in una nuova regola; il SOC monitora la regola e il piano di risposta viene aggiornato. Il valore non è solo trovare un attaccante, ma rendere più difficile la stessa intrusione in futuro.
Come si conduce un’attività efficace dentro la rete
Un’attività ben organizzata non parte dall’esplorazione casuale di milioni di log. Parte dal rischio più rilevante per l’azienda, dai suoi asset critici e dai comportamenti che un avversario dovrebbe adottare per raggiungerli.
1. Definire una domanda concreta
Una buona ipotesi è specifica e collegata a una tecnica d’attacco. Per esempio, si può verificare se esistono accessi anomali a sistemi finanziari, se un account privilegiato viene utilizzato fuori dall’orario abituale o se strumenti legittimi vengono impiegati per eseguire comandi sospetti.
Domande troppo generiche, come “cerchiamo malware”, producono risultati confusi. Io preferisco ipotesi legate a un asset, un comportamento e una finestra temporale. In questo modo il team sa cosa cercare e può valutare il risultato senza affidarsi a impressioni.
2. Scegliere le fonti di evidenza
L’ipotesi determina i dati necessari. Per studiare un possibile movimento laterale servono eventi di autenticazione, connessioni tra host, attività sugli endpoint e uso di account amministrativi. Per analizzare un accesso cloud sospetto possono essere più importanti i log di identità, i token, le modifiche alle autorizzazioni e le attività sulle applicazioni SaaS.
- Endpoint: processi avviati, file creati, modifiche al registro e connessioni in uscita.
- Identità: accessi, privilegi, autenticazione multifattore e utilizzo di account inattivi.
- Rete: DNS, proxy, firewall, flussi tra dispositivi e comunicazioni con infrastrutture esterne.
- Cloud: accessi alle API, cambi di configurazione, creazione di risorse e trasferimenti di dati.
- Applicazioni: operazioni anomale, errori ripetuti e utilizzo fuori dai normali schemi.
3. Cercare indicatori e comportamenti
Gli indicatori di compromissione, chiamati IOC, sono tracce come hash, domini o indirizzi IP. Gli indicatori di comportamento, spesso descritti come TTP, riguardano invece il modo in cui l’attaccante agisce. I primi sono utili per controlli rapidi, mentre i secondi resistono meglio quando l’avversario cambia strumenti.
Il framework MITRE ATT&CK aiuta a descrivere queste tecniche con un linguaggio comune. Non lo userei come una checklist da completare tutta in una volta: per una PMI italiana è più efficace selezionare le tecniche realmente plausibili per il proprio settore, per esempio furto di credenziali, accesso remoto, esecuzione tramite script e raccolta di dati.
4. Validare il segnale
Un evento anomalo non equivale automaticamente a un incidente. Un amministratore potrebbe aver eseguito uno script autorizzato, oppure un nuovo servizio cloud potrebbe aver generato traffico insolito. L’analista deve quindi ricostruire la sequenza, consultare il proprietario del sistema e cercare conferme indipendenti.
Un risultato affidabile dovrebbe chiarire che cosa è successo, quando, su quali sistemi e con quale livello di confidenza. Se la minaccia viene confermata, si attiva la risposta agli incidenti. Se l’ipotesi è smentita, il team conserva comunque la logica di ricerca e può usarla per migliorare la baseline.
Leggi anche: Air gap, come proteggere i sistemi critici senza illusioni
5. Trasformare la scoperta in una difesa
Il lavoro non finisce con il report. Bisogna creare o correggere una regola di rilevamento, eliminare privilegi eccessivi, migliorare la raccolta dei log oppure aggiornare una procedura operativa.
Un errore comune è contare il numero di query eseguite. La misura più utile è ciò che cambia dopo l’attività: una nuova detection, un rischio ridotto o una risposta più rapida. Senza questo passaggio, l’hunting resta un esercizio investigativo isolato.
Quali strumenti servono davvero
Il SIEM raccoglie e correla eventi provenienti da fonti diverse. È utile per analisi trasversali, ma da solo non garantisce visibilità sufficiente: se i log non arrivano, sono incompleti o vengono conservati per pochi giorni, anche la query migliore fallisce.
L’EDR offre telemetria dettagliata sugli endpoint, come processi, connessioni e attività degli utenti. L’NDR osserva invece il comportamento della rete, mentre le piattaforme di threat intelligence forniscono informazioni su gruppi, campagne, indicatori e tecniche osservate.
| Strumento | Punto di forza | Limite da considerare |
|---|---|---|
| SIEM | Correla eventi da molte fonti. | Richiede regole, normalizzazione e costi di conservazione. |
| EDR | Mostra ciò che accade sugli endpoint. | La copertura è debole sui dispositivi non gestiti. |
| NDR | Evidenzia flussi e anomalie di rete. | Il traffico cifrato riduce la profondità dell’analisi. |
| Threat intelligence | Orienta la ricerca verso minacce pertinenti. | Informazioni generiche generano molto rumore. |
| SOAR | Automatizza azioni ripetitive di risposta. | Un’automazione mal configurata può amplificare gli errori. |
Non consiglio di acquistare tutto subito. Per iniziare servono almeno inventario degli asset, gestione centralizzata delle identità, log affidabili e telemetria sugli endpoint critici. Una piccola azienda può condurre un pilot su 2 o 3 ipotesi ad alto rischio prima di estendere la raccolta dati all’intera infrastruttura.
L’intelligenza artificiale può aiutare a riassumere eventi, ordinare anomalie e proporre collegamenti, ma non sostituisce la verifica dell’analista. La qualità dei dati e delle domande resta più importante del numero di funzioni presenti nella piattaforma.
Come misurare i risultati e scegliere il modello operativo
Per capire se l’attività produce valore, suggerisco di seguire pochi indicatori coerenti. Il tempo medio di scoperta mostra quanto rapidamente si individua una presenza malevola; il tempo di validazione indica quanto serve per distinguere un’anomalia da un incidente reale.
- Numero di ipotesi testate e percentuale con esito verificabile.
- Tempo medio tra l’inizio dell’attività sospetta e la scoperta.
- Numero di detection nuove o migliorate dopo ogni hunt.
- Asset e account critici coperti dalla telemetria.
- Falsi positivi eliminati o ridotti.
- Tempo necessario per contenere una minaccia confermata.
Per un primo progetto è ragionevole pianificare 1 o 2 settimane per definire il perimetro, preparare i dati, eseguire le ricerche e documentare i risultati. Le attività ricorrenti possono richiedere da alcune ore a una giornata per ipotesi, in base alla maturità del SOC e alla qualità dei log. Sono stime operative, non tariffe di mercato: il costo reale dipende da dimensione, tecnologia e livello di supporto richiesto.
Un team interno offre conoscenza profonda dei processi aziendali, ma richiede competenze difficili da mantenere. Un servizio gestito può garantire maggiore continuità e accesso a specialisti, però va valutato con attenzione: bisogna verificare tempi di escalation, responsabilità, conservazione dei dati e capacità di spiegare i risultati in termini comprensibili al management.
Per molte PMI funziona un modello ibrido. Il partner conduce le analisi più specialistiche, mentre il personale interno definisce gli asset prioritari, valida i falsi positivi e decide quali contromisure adottare. La responsabilità sulle decisioni non dovrebbe essere delegata insieme alla tecnologia.
Gli errori che fanno perdere valore alla ricerca proattiva
Il primo errore è cercare ovunque senza una priorità. Un ambiente aziendale genera troppi eventi per essere analizzato interamente a mano, quindi bisogna concentrare l’attenzione su identità privilegiate, dati sensibili, sistemi esposti e percorsi plausibili di attacco.
Il secondo è usare soltanto IOC. Gli indirizzi e gli hash cambiano rapidamente; una difesa costruita solo su questi elementi rischia di non vedere una campagna che utilizza strumenti diversi. Le ricerche dovrebbero includere anche sequenze di comportamento e relazioni tra eventi.
Un altro problema frequente riguarda la telemetria. Conservare log inutilizzabili, senza sincronizzazione dell’orario o senza il contesto dell’utente, crea una falsa sensazione di controllo. Prima di ampliare il numero di dashboard, conviene controllare che i dati siano completi, consultabili e conservati abbastanza a lungo per ricostruire un’attività.
Infine, non bisogna trasformare ogni anomalia in una crisi. Un processo maturo assegna livelli di confidenza, documenta le spiegazioni legittime e stabilisce in anticipo quando isolare un dispositivo, disabilitare un account o coinvolgere il responsabile della sicurezza.
La maturità si vede da ciò che cambia dopo ogni ricerca
Un programma efficace non si misura dal numero di strumenti acquistati né dalla quantità di alert visualizzati. Si riconosce dal fatto che ogni analisi lascia qualcosa di migliore: una regola più precisa, un log finalmente disponibile, un privilegio ridotto o una procedura di risposta più rapida.
Il mio approccio pratico è iniziare con due ipotesi legate ai rischi più costosi per il business, testarle su un perimetro limitato e misurare ciò che è stato scoperto. Dopo 30 giorni si può decidere se ampliare la copertura, affidarsi a un partner esterno o investire in nuove capacità tecniche.
La ricerca proattiva non promette di rendere una rete invulnerabile. Offre qualcosa di più concreto: la possibilità di scoprire prima ciò che i controlli automatici non hanno visto e di trasformare ogni scoperta in una difesa più adatta alla realtà dell’azienda.
