Una gestione ordinata degli incidenti trasforma il caos in decisioni rapide
- Obiettivo principale: contenere la minaccia, proteggere le prove e ripristinare i servizi prioritari.
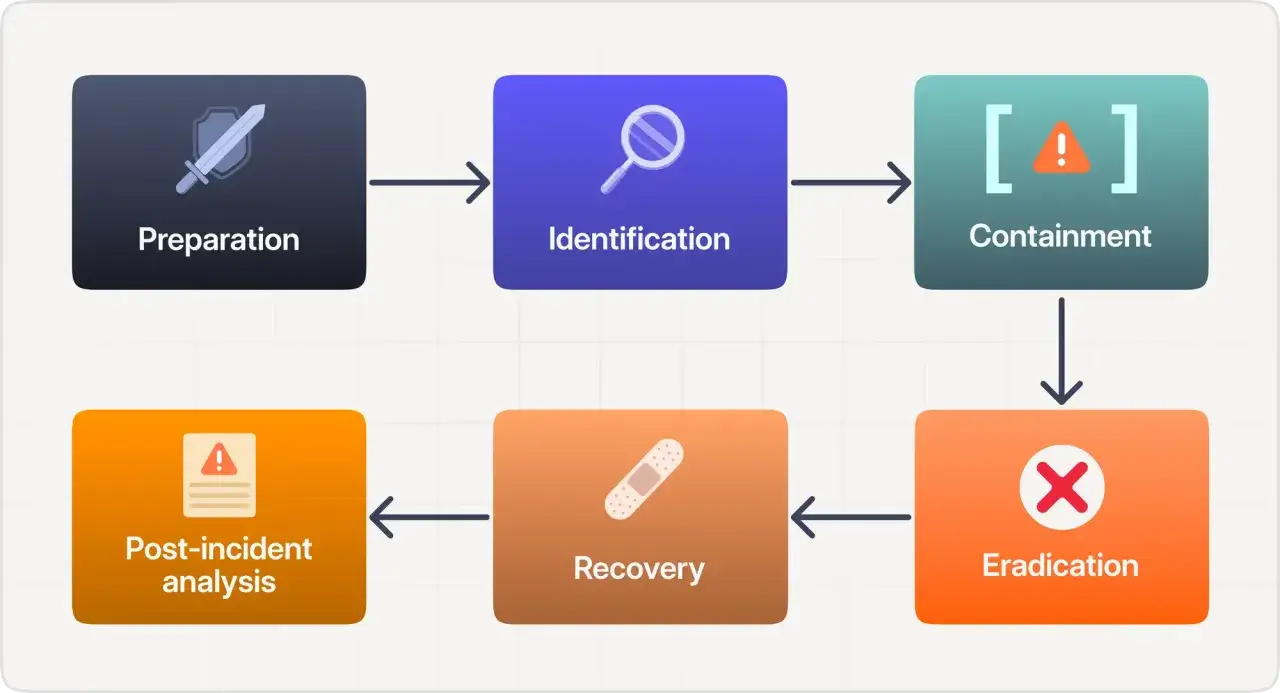
- Fasi essenziali: preparazione, rilevamento, analisi, contenimento, eliminazione, recupero e miglioramento.
- Tempi da conoscere: il GDPR può richiedere la notifica al Garante entro 72 ore, mentre NIS2 prevede finestre di 24, 72 ore e un mese per gli enti interessati.
- Errore più comune: isolare i sistemi senza coordinare IT, direzione, legale e comunicazione.
- Misura decisiva: testare il piano prima dell’emergenza, non durante il ransomware.
Che cosa comprende davvero la gestione di un incidente informatico
Un incidente di sicurezza è qualunque evento che comprometta la riservatezza, l’integrità o la disponibilità di sistemi e informazioni. Può trattarsi di ransomware, furto di credenziali, accesso abusivo a un account, perdita di un computer aziendale, attacco DDoS o errore umano con conseguenze operative.
Non ogni avviso è già una violazione. Un allarme dell’antivirus può rivelarsi un falso positivo, mentre un accesso anomalo a un account privilegiato richiede attenzione anche se non è ancora chiaro che i dati siano stati sottratti. Io consiglio di distinguere almeno tre livelli.
| Livello | Esempio | Risposta necessaria |
|---|---|---|
| Evento | Un login da una posizione insolita | Verifica e raccolta dei log |
| Incidente | Credenziali utilizzate da un soggetto non autorizzato | Analisi, blocco dell’accesso e ricerca di eventuali movimenti laterali |
| Crisi | Ransomware che ferma produzione e servizi clienti | Coordinamento aziendale, continuità operativa e comunicazione esterna |
La distinzione serve a non mobilitare tutta l’azienda per ogni notifica, ma anche a non sottovalutare un segnale importante. La decisione deve dipendere da impatto, ampiezza, criticità dei sistemi e probabilità di propagazione, non soltanto dal nome della minaccia.
Le fasi operative da seguire quando scatta l’allarme
Un buon piano non è un documento da conservare in una cartella dimenticata. È una sequenza di azioni brevi, con responsabili già indicati e autorizzazioni definite. Il modello NIST SP 800-61 Rev. 3, pubblicato nel 2025, integra la risposta agli incidenti nella gestione generale del rischio e non la considera un’attività isolata del reparto IT.
Preparazione e rilevamento
Prima dell’attacco bisogna sapere quali sistemi esistono, quali dati trattano e chi può intervenire. Servono una lista aggiornata dei contatti, backup verificati, accessi di emergenza tracciati, raccolta centralizzata dei log e procedure per disabilitare account, ruotare chiavi e isolare dispositivi.Il rilevamento può arrivare da un SIEM, da un EDR, da un dipendente o da un fornitore. Non bisogna aspettare la certezza assoluta prima di aprire un caso. È più prudente registrare l’evento, assegnargli una priorità e raccogliere le prime evidenze senza alterarle.
Analisi e classificazione
In questa fase il team deve rispondere a domande concrete. Qual è il punto d’ingresso? Quali account e dispositivi sono coinvolti? L’attaccante è ancora presente? Sono stati toccati dati personali, sistemi produttivi o servizi essenziali?
Io separo sempre i fatti dalle ipotesi. Un registro con orari, decisioni, persone coinvolte e prove raccolte aiuta sia l’indagine tecnica sia eventuali comunicazioni al Garante, alle autorità o ai clienti.
Contenimento
Il contenimento serve a impedire che l’incidente si allarghi. Può significare isolare un endpoint, bloccare un account, disattivare una VPN, filtrare un dominio malevolo o separare una rete compromessa da quella produttiva.
Qui emerge un compromesso delicato. Spegnere tutto può fermare l’attacco, ma può anche distruggere dati utili all’analisi e paralizzare l’attività. La scelta migliore dipende dalla minaccia e dal valore del sistema, quindi deve essere presa con una regola di escalation già concordata.
Eradicazione e recupero
Dopo il contenimento bisogna rimuovere la causa, non solo il sintomo. Occorre eliminare malware, correggere la vulnerabilità sfruttata, revocare token e credenziali, controllare gli account privilegiati e verificare che non esistano persistenze nascoste.
Il ripristino deve partire dai servizi più importanti e da backup realmente affidabili. Un backup non testato è una promessa, non una capacità di recupero. Per ogni sistema critico definisco un RTO, cioè il tempo massimo accettabile per tornare operativi, e un RPO, cioè la quantità massima di dati che si può perdere.
Leggi anche: Carta di credito clonata, quanto tempo serve per il rimborso?
Lezioni apprese
La chiusura tecnica non coincide con la fine dell’incidente. Entro pochi giorni conviene organizzare una revisione senza caccia al colpevole, individuando ciò che ha rallentato la risposta e assegnando azioni con una scadenza.
Un incidente ben gestito lascia almeno un risultato utile, come una regola di rilevamento migliore, un accesso ridotto, una procedura più chiara o un backup più robusto. Se non cambia nulla, la prossima risposta sarà probabilmente altrettanto lenta.
Persone, ruoli e strumenti che fanno la differenza
La risposta non appartiene soltanto al responsabile IT. Un incidente serio coinvolge almeno un coordinatore, analisti tecnici, il referente privacy, il legale, la direzione, la comunicazione e, quando necessario, il fornitore di sicurezza o il provider cloud.
| Ruolo | Responsabilità principale |
|---|---|
| Incident manager | Coordina il caso, stabilisce priorità e documenta le decisioni. |
| Team tecnico | Analizza log e dispositivi, contiene la minaccia e gestisce il ripristino. |
| Referente privacy | Valuta i dati personali coinvolti e gli obblighi di notifica. |
| Direzione | Approva decisioni con impatto economico, operativo e reputazionale. |
| Comunicazione e legale | Preparano messaggi coerenti verso clienti, dipendenti, autorità e partner. |
Per una piccola impresa non è indispensabile avere un SOC interno attivo 24 ore su 24. È però necessario sapere chi risponde di notte e chi può autorizzare un blocco operativo. Un servizio MDR esterno può offrire monitoraggio e competenze, ma non sostituisce le decisioni aziendali né la conoscenza dei processi interni.
Gli strumenti più utili sono spesso meno spettacolari di quanto si racconti. EDR, autenticazione multifattore, gestione centralizzata dei log, backup immutabili e un sistema di ticketing con cronologia completa fanno più differenza di una piattaforma costosa usata solo in parte.GDPR e NIS2 cambiano il modo di reagire in Italia
Un incidente informatico può essere anche una violazione di dati personali. Secondo il Garante Privacy, la notifica è dovuta senza ingiustificato ritardo e, quando possibile, entro 72 ore dalla conoscenza della violazione, se è probabile un rischio per i diritti e le libertà delle persone.
Il termine decorre dalla consapevolezza della violazione, non dal momento in cui l’indagine ha già ricostruito ogni dettaglio. Per questo consiglio di attivare subito una valutazione documentata, anche quando alcune informazioni sono ancora provvisorie. Se il rischio è elevato, può essere necessario informare direttamente gli interessati.
Per gli enti essenziali e importanti soggetti alla NIS2, la disciplina europea prevede una sequenza distinta per gli incidenti significativi.
| Scadenza | Adempimento | Contenuto minimo |
|---|---|---|
| Entro 24 ore | Early warning | Segnalazione iniziale, possibile origine dolosa e impatto transfrontaliero, se noto. |
| Entro 72 ore | Notifica dell’incidente | Valutazione iniziale di gravità, impatto e indicatori di compromissione disponibili. |
| Entro un mese | Relazione finale | Descrizione, causa probabile, misure di mitigazione e impatto transfrontaliero, se applicabile. |
GDPR e NIS2 possono applicarsi allo stesso evento, ma non sono la stessa cosa. Il primo tutela le persone e i loro dati, mentre la seconda riguarda la resilienza e la sicurezza dei servizi coperti. La gestione corretta richiede quindi una mappa degli obblighi, con destinatari, tempi e responsabili già associati a ogni scenario.
Gli errori che rallentano la risposta e aggravano i danni
Il primo errore è aspettare una diagnosi perfetta. Durante un ransomware, ogni ora può aumentare il numero di sistemi cifrati o di dati copiati. Bisogna agire sulla base delle evidenze disponibili e aggiornare le decisioni man mano che emergono nuovi elementi.
Il secondo è comunicare senza coordinamento. Un dipendente che pubblica dettagli non verificati può complicare l’indagine, allarmare i clienti o contraddire una notifica ufficiale. Io preparo sempre un unico punto di contatto e messaggi approvati per i diversi destinatari.
Un altro problema frequente consiste nel ripristinare troppo presto. Riaccendere un server prima di aver eliminato l’accesso dell’attaccante può causare una nuova compromissione. Prima del ritorno alla normalità servono controlli su credenziali, configurazioni, sistemi aggiornati e attività anomale.
Infine, molte aziende dimenticano i fornitori. Un account cloud, un gestionale o un partner logistico possono essere il vero punto d’ingresso. Contratti e procedure dovrebbero stabilire chi avvisa chi, entro quanto tempo e con quali informazioni.
Come capire se il piano funziona davvero
Non misuro la maturità di un programma dal numero di pagine del documento. Guardo piuttosto quanto tempo serve per rilevare l’incidente, contenere l’account compromesso, ripristinare il servizio e prendere una decisione senza riunioni interminabili.
- MTTD: tempo medio necessario per rilevare un’attività sospetta.
- MTTC: tempo medio necessario per contenere la minaccia.
- MTTR: tempo medio necessario per recuperare il servizio.
- Copertura dei log: percentuale dei sistemi critici realmente monitorati.
- Test di ripristino: frequenza con cui i backup vengono recuperati con successo.
- Azioni chiuse: numero di correzioni completate dopo incidenti ed esercitazioni.
Una simulazione da 30-60 minuti ogni trimestre può bastare per iniziare, usando scenari realistici come un account amministrativo rubato o un fornitore cloud indisponibile. L’obiettivo non è mettere in scena un esercizio perfetto, ma scoprire chi non ha accesso ai contatti, quali autorizzazioni mancano e quali sistemi non possono essere ripristinati.
Per una PMI, il primo traguardo concreto è un runbook di una pagina per i casi più probabili. Deve indicare azioni, responsabili, numeri di emergenza, criteri di escalation e modalità di conservazione delle prove. Solo dopo ha senso investire in automazioni più sofisticate.
La resilienza si costruisce prima del prossimo allarme
Una risposta efficace nasce da preparazione, ruoli chiari e strumenti verificati. Non elimina ogni attacco, ma riduce il tempo di esposizione, limita l’interruzione dei servizi e rende più solide le decisioni dell’azienda.
La mia raccomandazione è semplice. Entro i prossimi sette giorni nominate un responsabile, controllate i backup, aggiornate i contatti e simulate uno scenario concreto. È un lavoro poco appariscente, ma spesso è ciò che separa un incidente gestibile da una crisi capace di fermare l’intera organizzazione.
