Quando un’app, un sito o un software raccoglie più informazioni del necessario, la privacy diventa un problema già prima che l’utente possa intervenire. Il principio del privacy by default serve proprio a evitare questo scenario: spiego cosa significa, quali impostazioni adottare e come applicarlo concretamente in aziende, siti web, app e strumenti basati sull’intelligenza artificiale.
La protezione dei dati deve partire dalle impostazioni iniziali
- Impostazioni restrittive attivate automaticamente, senza obbligare l’utente a cercarle.
- Solo i dati necessari raccolti per una finalità specifica e dichiarata.
- Consenso libero e granulare, mai ottenuto tramite caselle preselezionate o interfacce ingannevoli.
- Accessi, conservazione e condivisioni limitati fin dalla progettazione del servizio.
- Controlli periodici per verificare che le impostazioni iniziali restino davvero protettive.
Che cosa significa davvero proteggere i dati per impostazione predefinita
In parole semplici, l’utente deve essere protetto anche se non modifica nessuna impostazione. Un nuovo account, un’app appena installata o un software aziendale dovrebbero partire con il livello di riservatezza più prudente compatibile con il servizio, non con la configurazione più utile alla raccolta di dati.
L’articolo 25 del GDPR collega questo principio alla protezione dei dati fin dalla progettazione e per impostazione predefinita. La prima riguarda il modo in cui il prodotto viene ideato; la seconda riguarda ciò che succede automaticamente quando il prodotto viene utilizzato per la prima volta. Sono due piani diversi, ma devono funzionare insieme.
Per esempio, un social network può essere progettato per offrire controlli granulari sulla visibilità dei contenuti. Se però il profilo è pubblico, la geolocalizzazione è attiva e la condivisione con terze parti è preselezionata, la protezione predefinita rimane debole. La possibilità di cambiare un’opzione non basta se l’impostazione iniziale spinge l’utente nella direzione opposta.
Il principio non impone di rendere inutilizzabile un servizio. Significa piuttosto scegliere, tra più configurazioni possibili, quella che limita la quantità di dati raccolti, il numero di soggetti che possono accedervi, il periodo di conservazione e l’uso per finalità ulteriori.
Quali dati e impostazioni devono essere limitati all’origine
La protezione predefinita non si esaurisce nel pulsante “accetta cookie”. Riguarda l’intero ciclo di vita delle informazioni, dalla raccolta alla cancellazione. Quando analizzo un processo, parto da quattro domande molto concrete: quali dati vengono raccolti, per quale scopo, chi li vede e quando vengono eliminati.
Raccogliere soltanto ciò che serve
Un e-commerce può aver bisogno di nome, indirizzo e dati di pagamento per completare un ordine. Non ha automaticamente bisogno della data di nascita, della rubrica del telefono o della posizione precisa. Il principio di minimizzazione impone di non trasformare ogni dato disponibile in un campo obbligatorio.
Una buona impostazione predefinita rende facoltativi i dati non indispensabili e spiega con chiarezza perché vengono richiesti. Se l’informazione serve solo per una funzione opzionale, dovrebbe essere raccolta solo quando l’utente attiva quella funzione.
Tenere separati gli scopi
I dati raccolti per consegnare un prodotto non dovrebbero finire automaticamente in una campagna di profilazione. Marketing, analisi statistica, personalizzazione e assistenza clienti sono finalità diverse e devono avere impostazioni distinte.
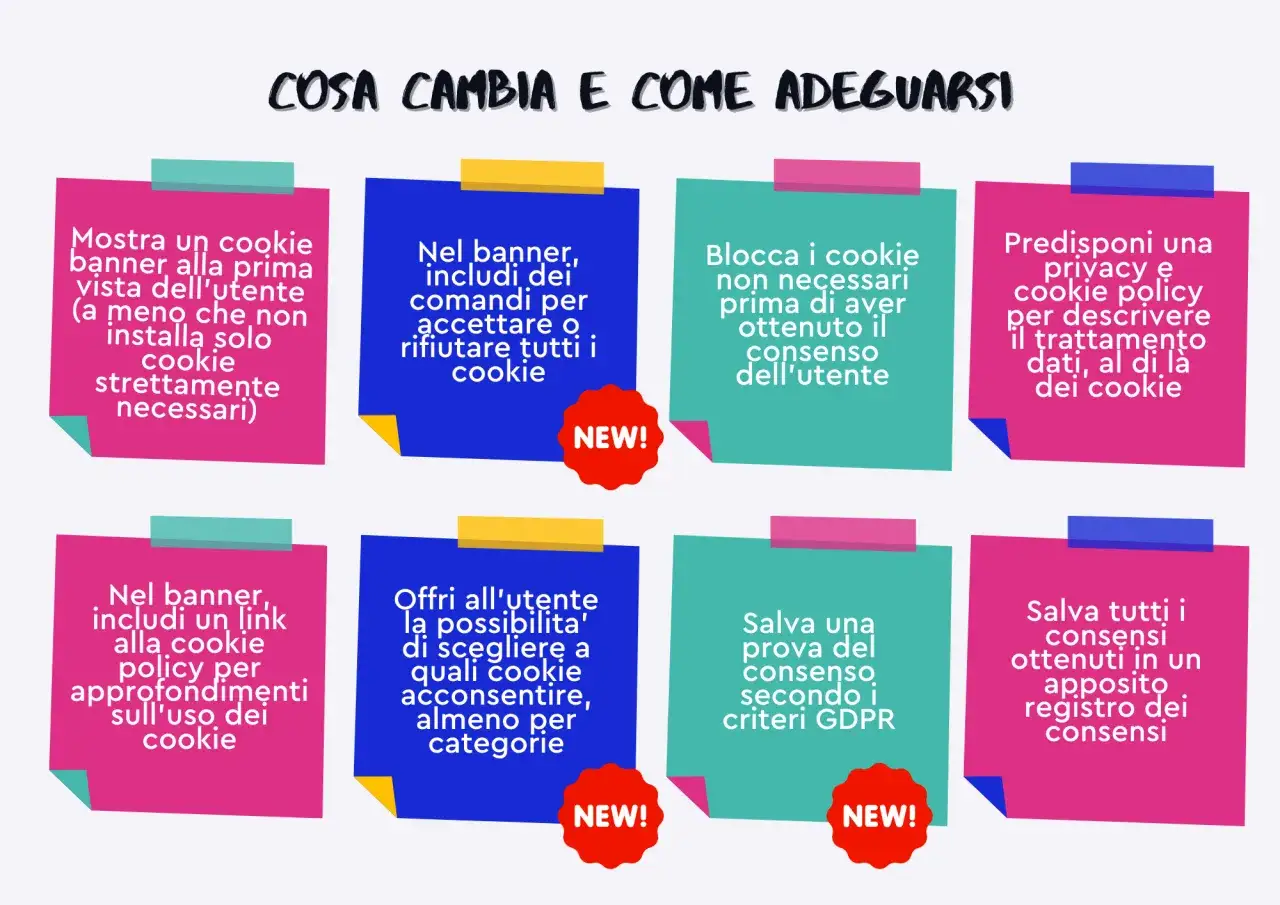
Nei banner cookie, per esempio, i cookie tecnici necessari possono essere attivi, mentre analytics, pubblicità comportamentale e tracciamento tra siti dovrebbero partire disattivati. Il Garante Privacy italiano ha ribadito che anche le scelte granulari devono essere inizialmente impostate sul diniego.
Limitare accessi e condivisioni
In un gestionale aziendale, un dipendente dell’ufficio commerciale non deve vedere per impostazione predefinita i dati sanitari o le informazioni disciplinari del personale. Qui entrano in gioco i permessi basati sul ruolo, cioè regole che collegano l’accesso alle mansioni effettive della persona.
Lo stesso criterio vale per fornitori, agenzie e piattaforme cloud. Un servizio dovrebbe condividere solo i dati necessari all’attività affidata, con accessi temporanei quando possibile e senza lasciare attivi account che non vengono più utilizzati.
Stabilire tempi di conservazione realistici
Conservare tutto “per sicurezza” è una delle abitudini più costose e rischiose. Un sistema ben configurato prevede scadenze automatiche, revisioni periodiche e cancellazioni documentate. Le tempistiche dipendono dalla finalità, dagli obblighi di legge e dal tipo di dato, quindi non esiste un numero valido per ogni azienda.
Come regola operativa, preferisco definire un periodo preciso per ogni categoria, invece di usare formule vaghe come “fino a quando necessario”. Un dato che non serve più dovrebbe uscire dal sistema, non restare disponibile soltanto perché nessuno ha ancora premuto il tasto elimina.
Come applicare il principio in un’azienda italiana
Per una PMI non serve iniziare con un progetto enorme. Un percorso pratico può essere completato in alcune settimane, concentrandosi sui trattamenti che coinvolgono più persone o dati più delicati. La prima attività utile è costruire una mappa semplice dei sistemi utilizzati.
- Elencare i trattamenti presenti in sito, CRM, newsletter, strumenti HR, assistenza e piattaforme cloud.
- Indicare la finalità di ogni trattamento e separare ciò che è necessario da ciò che è solo utile.
- Controllare le impostazioni iniziali di raccolta, condivisione, visibilità, conservazione e profilazione.
- Ridurre i privilegi degli utenti interni e dei fornitori al minimo indispensabile.
- Documentare le scelte tecniche e organizzative, comprese le motivazioni delle eccezioni.
- Testare il percorso utente con un account nuovo, verificando cosa accade senza modificare nulla.
Il test dell’account nuovo è spesso quello che fa emergere i problemi più evidenti. Si scopre, per esempio, che una newsletter è già attiva, che il profilo è visibile nei motori di ricerca o che una piattaforma invia dati diagnostici a un fornitore esterno. La configurazione reale conta più della policy scritta.
Chi deve occuparsene
La responsabilità non appartiene soltanto al consulente privacy o al responsabile IT. Chi definisce il prodotto decide quali dati raccogliere, chi progetta l’interfaccia stabilisce quanto è facile rifiutare, mentre il reparto commerciale può introdurre strumenti di marketing con impostazioni troppo permissive.
Io coinvolgerei almeno quattro ruoli: titolare o management, referente privacy, area tecnica e responsabile del processo. In una piccola impresa una sola persona può coordinare il lavoro, ma le decisioni devono restare tracciate e comprensibili.
Come misurare se l’adozione funziona
Non basta dichiarare che la privacy è importante. Si possono verificare indicatori pratici come il numero di campi obbligatori, la percentuale di account con autenticazione a più fattori, i dati conservati oltre il termine stabilito e il numero di integrazioni che ricevono informazioni personali.
Per un primo controllo suggerisco una revisione ogni 6 o 12 mesi, oltre a una verifica ogni volta che cambia un fornitore, una funzione o una finalità. Nei trattamenti ad alto rischio possono servire analisi più frequenti e una valutazione d’impatto sulla protezione dei dati.
Gli esempi più concreti tra siti, app e strumenti AI
Il modo migliore per capire il principio è osservare cosa dovrebbe accadere nella pratica. Gli esempi cambiano a seconda del servizio, ma hanno tutti lo stesso punto di partenza: la scelta più invasiva non può essere quella automatica.
Siti web e cookie
Un sito può attivare senza consenso i cookie strettamente necessari al funzionamento, come quelli utili alla sicurezza o alla gestione della sessione. Analytics, pubblicità e profilazione dovrebbero invece restare inattivi finché l’utente non esprime una scelta valida.
Il pulsante per rifiutare deve essere visibile quanto quello per accettare. Nascondere il rifiuto in un secondo livello o usare colori molto diversi crea pressione e può trasformare il banner in un dark pattern, cioè un’interfaccia progettata per orientare l’utente verso una scelta che non avrebbe fatto con la stessa facilità.
App mobili
Un’app per la consegna di cibo può chiedere la posizione precisa soltanto mentre l’utente sta cercando ristoranti nelle vicinanze. Non è ragionevole mantenerla attiva in ogni momento se il servizio può funzionare anche inserendo manualmente un indirizzo.
Lo stesso vale per contatti, microfono, fotocamera e notifiche. L’accesso dovrebbe essere richiesto nel momento in cui serve, con una spiegazione comprensibile e un’alternativa quando la funzione principale rimane disponibile senza quel permesso.
Software aziendale e cloud
In una piattaforma di gestione documentale, i file appena caricati dovrebbero essere visibili soltanto al gruppo di lavoro autorizzato. La condivisione tramite link pubblico, l’accesso anonimo e la conservazione illimitata non dovrebbero mai essere le impostazioni iniziali.
Prima di acquistare un SaaS, controllerei se l’amministratore può modificare le impostazioni di base, esportare i dati, definire i tempi di cancellazione e ottenere informazioni sui subfornitori. La flessibilità di configurazione è spesso più importante di una lunga lista di funzioni.
Strumenti di intelligenza artificiale
Con i sistemi AI il rischio riguarda soprattutto i prompt, i documenti caricati e la possibilità che i contenuti vengano utilizzati per migliorare il servizio. Un’azienda dovrebbe partire da account separati, impostazioni che escludano l’uso dei dati per finalità ulteriori e regole chiare sui documenti riservati.
Non inserirei mai automaticamente dati sanitari, informazioni finanziarie o segreti commerciali in uno strumento senza aver verificato contratto, conservazione e accessi. La comodità dell’AI non giustifica la perdita di controllo sui dati, soprattutto quando esistono alternative tecniche meno esposte.
Gli errori che rendono debole una protezione apparentemente corretta
Il primo errore è confondere una buona informativa con una buona configurazione. Un documento può spiegare perfettamente il trattamento, ma non corregge un modulo che rende obbligatori dati superflui o un’app che attiva il tracciamento prima del consenso.
Un altro problema frequente è usare la sicurezza come giustificazione per raccogliere tutto. La sicurezza richiede misure adeguate, non una raccolta senza limiti. Crittografia, autenticazione forte, segmentazione degli accessi e registri degli eventi possono ridurre il rischio senza moltiplicare i dati personali disponibili.
Privacy e usabilità non sono nemiche
Un’impostazione restrittiva può richiedere un clic in più o ridurre la personalizzazione iniziale. È un compromesso accettabile quando la funzione principale resta chiara e accessibile. Il problema nasce quando il servizio viene progettato in modo da rendere la tutela così scomoda che l’utente finisce per rinunciarvi.
La soluzione migliore è offrire scelte semplici all’inizio e opzioni avanzate in un secondo momento. Proteggere di più non significa spiegare di più: spesso significa progettare meglio il percorso.
Leggi anche: Responsabile del trattamento GDPR - regole e controlli
Quando il default non è sufficiente
Le impostazioni iniziali riducono il rischio, ma non sostituiscono la formazione del personale, la gestione degli incidenti o la valutazione dei fornitori. Un account configurato correttamente può comunque essere compromesso da una password riutilizzata o da un accesso lasciato attivo.
Per questo affiancherei al controllo delle impostazioni almeno autenticazione a più fattori, aggiornamenti regolari, backup protetti e una procedura per revocare rapidamente gli accessi. Nei progetti con dati sensibili, la valutazione d’impatto può essere necessaria prima dell’avvio del trattamento.
La protezione predefinita come scelta operativa per il business
Applicare questo principio non significa rallentare ogni progetto digitale. Significa decidere in anticipo quali dati sono davvero indispensabili, quali funzioni devono restare disattivate e quali persone possono accedere alle informazioni.
Il vantaggio non è soltanto normativo. Un’azienda che raccoglie meno dati riduce la superficie di attacco, semplifica i processi e comunica più chiaramente il proprio modo di lavorare. La mia regola è semplice: se una funzione non è necessaria per partire, non dovrebbe partire da sola.
Quando questa logica entra nei requisiti tecnici, nei contratti con i fornitori e nei test prima del rilascio, la privacy smette di essere una correzione tardiva e diventa una qualità concreta del prodotto. È qui che le impostazioni predefinite fanno davvero la differenza.
